Automação e Engenharia de Dados
RPA Report Pipeline
Case técnico
Problema
A extração de relatórios dependia de acessos manuais ao sistema, seleção de filtros, períodos e unidades, download de múltiplas planilhas e posterior consolidação dos arquivos. Além do tempo gasto em tarefas repetitivas, o processo estava sujeito a erros humanos, inconsistências entre arquivos e retrabalho durante a preparação dos dados para análise.
Solução
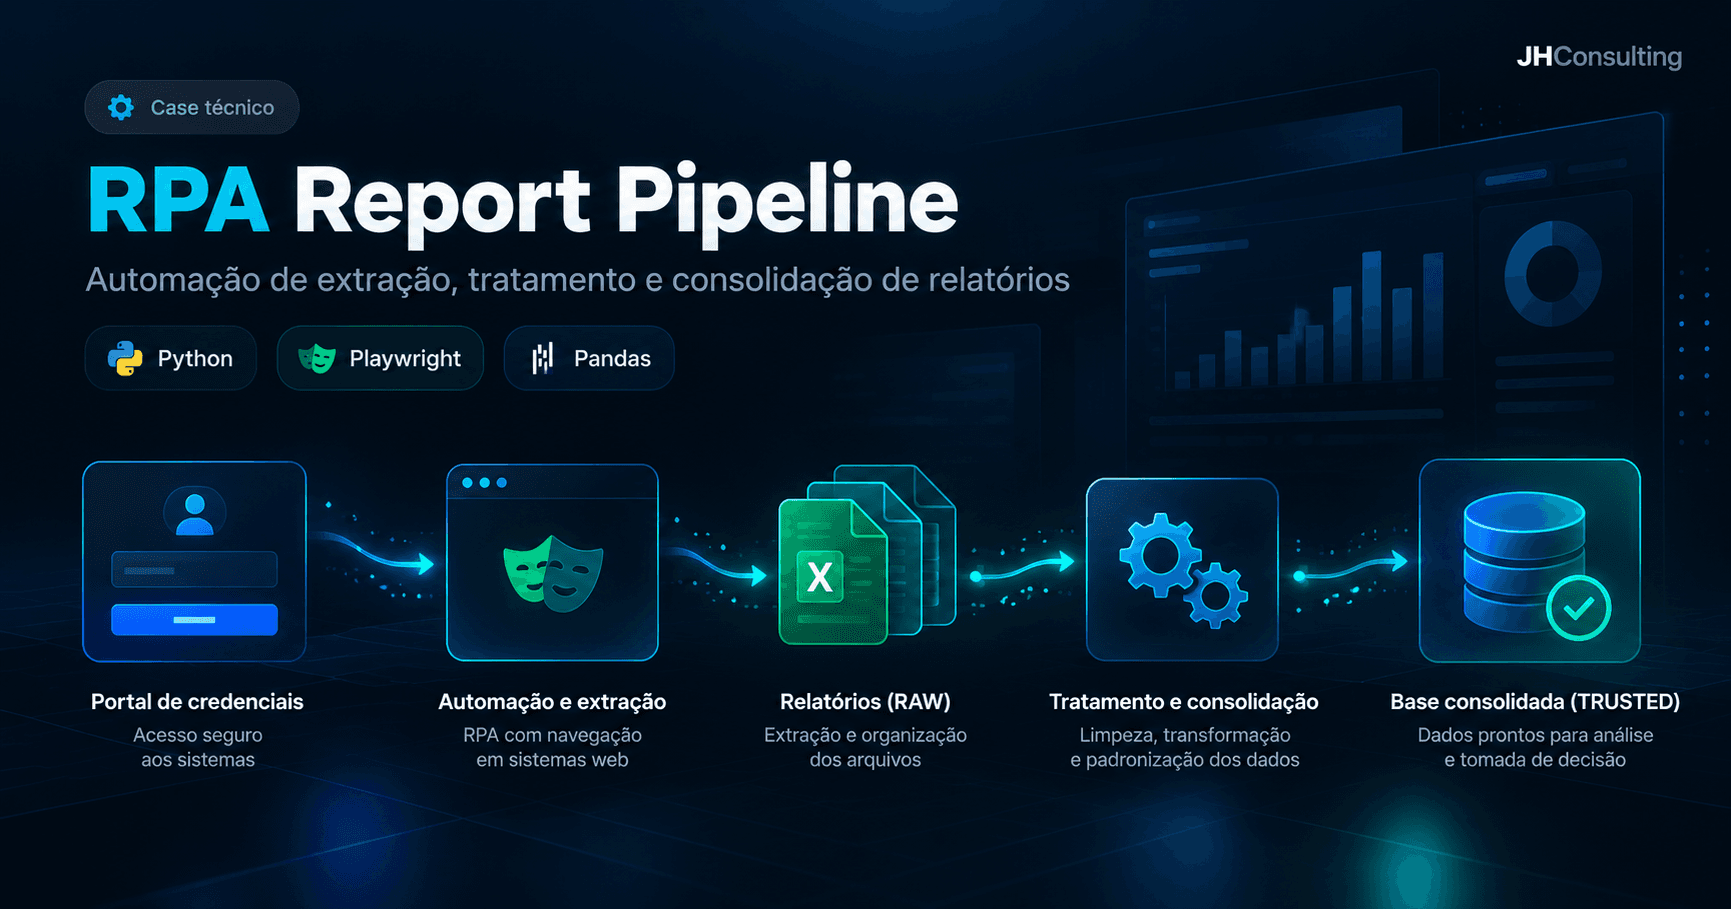
Foi desenvolvido um pipeline automatizado em Python utilizando Playwright para controlar o navegador, acessar o portal de credenciais, autenticar no sistema de relatórios e executar as extrações automaticamente. Os arquivos são armazenados inicialmente em uma camada RAW e posteriormente processados com Pandas, NumPy e OpenPyXL, gerando bases consolidadas e padronizadas na camada TRUSTED, prontas para análise.
Sobre o projeto
O RPA Report Pipeline foi desenvolvido para automatizar um processo recorrente de extração, organização e consolidação de relatórios provenientes de um sistema de gestão.
O fluxo anteriormente exigia a execução manual de diversas etapas: acessar sistemas, localizar credenciais, realizar autenticação, configurar filtros, selecionar períodos e unidades, executar relatórios, baixar planilhas e posteriormente preparar os arquivos para análise.
Para eliminar essas etapas repetitivas, foi construída uma automação em Python utilizando Playwright e Chromium em modo headless.
A automação inicia acessando um portal de credenciais responsável por disponibilizar as informações necessárias para autenticação no sistema-alvo. Após localizar o cliente e o sistema correspondente, o processo recupera os dados de acesso e inicia automaticamente a extração dos relatórios.
Os arquivos obtidos são organizados seguindo uma arquitetura de dados dividida em duas camadas.
Na camada RAW são armazenados os relatórios exatamente como foram disponibilizados pelo sistema de origem, preservando os dados brutos.
Na camada TRUSTED os arquivos são processados utilizando Pandas, NumPy e OpenPyXL. Nessa etapa são realizadas operações de limpeza, padronização de datas, tratamento de valores, criação de identificadores, resolução de relacionamentos entre diferentes relatórios e consolidação das informações.
Entre os relatórios processados estão dados de faturamento, movimentações financeiras, convênios, planos e materiais utilizados.
O pipeline também possui tratamento de exceções, logging das execuções e configuração por variáveis de ambiente, evitando que credenciais ou informações sensíveis sejam armazenadas diretamente no código.
A arquitetura foi estruturada para permitir a inclusão de novos clientes e novos relatórios sem a necessidade de reconstruir toda a automação.
O resultado é um processo automatizado capaz de transformar múltiplas planilhas extraídas de sistemas web em bases estruturadas e prontas para utilização em análises, dashboards e outros processos de dados.
Tem um desafio parecido?
Conte o processo que você quer melhorar e receba um diagnóstico inicial.